这一周,我主要在优化一个服务。这个服务是用 Java 编写的。生产环境流量不大的时候, 也会出现调用批量超时的现象。而且发送超时的时候,CPU 占用率很低。经过观察,CPU 占用一直就上不去。这个时候就推测是不是线程都阻塞在了某个操作上,导致这个问题。我所接触到的大多数服务,包括这个服务,都是 IO 密集型的服务。
这类服务涉及大量的 RPC 调用,当 RPC 调用的时候,工作线程会阻塞,导致无法处理其他请求。所以这类服务的工作线程数都会设置得很大,确保有多余线程来处理 IO 请求,防止由于大部分线程阻塞导致后续请求得不到处理,最终导致大批量超时。 这其实是有问题的,虽然说目前 Java 在处理 Socket 和解析 Request 的时候已经采取了 NIO 的模式,但是对于请求的逻辑处理依然采用工作线程池的方式。当遇到工作线程阻塞在 IO 请求上的时候,这个工作线程只能等待 IO 请求完成或者超时。如果说,IO 请求所返回的结果并不是该请求最终结果的依赖,这种情况会将请求提交到其他线程池处理。这个时候它的处理对于该工作线程来说是异步的。
最后经过排查,这个服务由于框架问题,有关于工作线程数量的配置并未被读取。这导致了该服务启动时采取了默认的工作线程的数量设置,也就是工作线程数和 CPU 核心数相同。所以,工作线程在处理下游 RPC 调用时,只要下游接口的耗时稍微有波动,就会导致大量请求超时。这个时候,由于工作线程大部分时间阻塞在等待 IO 操作返回上,所以 CPU 占用也是很少的。 如何排查的呢,首先需要在日志框架中设置打印当前线程名称,对于 logback 日志框架,就是在日志格式设置中加上%t。然后,对单个节点在测试环境进行压测,查看在一定 QPS 下,该服务对于请求的处理情况。最好能给这个请求的逻辑代码加上 StopWatch,辅助进行分析。最后发现,输出日志的线程只有几个,不对劲。然后,使用 jstack 过滤出线程数量。发现确实只有四个。
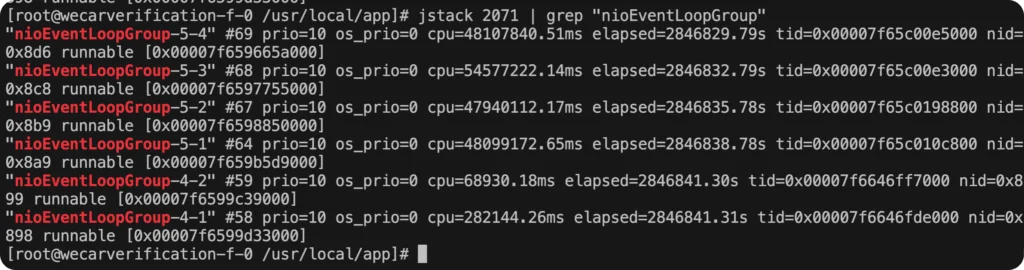
可以解释一下,这个 Java 服务使用的框架采用了 netty 框架进行请求的处理,最后会转交到 netty 的工作线程池对请求的逻辑进行处理。在这里,netty 工作线程池对应的前缀就是 nioEventLoopGroup-5。另外可以从 cpu 累计时间来辅助证明,确实只有这 4 个线程在处理所有的请求的主要逻辑。对于这种服务来说,生产环境下,工作线程数量一般设置为 800~1000,并且会严格设置 RPC 调用的超时时间防止大量工作线程被阻塞,最终导致节点的吞吐量急剧下降。 在更新框架后,该问题得到了解决。另外,我还发发现了该服务的一个主要接口涉及基于 http 协议的下游调用。该调用通过操作 OkHttp 库来进行,我发现调用并未设置超时时间。这是错误的情况,如果遇到极端情况,下游迟迟不返回,那么工作线程就会阻塞很久。所以,必须对下游调用设置一个合理的超时时间来保护上下游调用之间的通畅,防止雪崩现象的发生。超时时间一般分为三种,连接超时、读超时、写超时,都需要设置。另外,对于可能存在大量的 Http 调用情况,我开启了 OkHttp 的 ConnectionPool。
根据文档,ConnectionPool 的优势在于,多个同一地址的 http 或者 http/2 请求可以共用同一个连接。但需要注意,这个共享的前提是服务端支持 http 长连接。 另外,这周还主要去看了腾讯云的高级架构师 TCP 的相关内容,因为考试安排在周末。这个 TCP 考试比原来的架构师、从业者考试难度大了些,还是需要好好准备的。上班没太多时间看,所以我重物直接复习到周六凌晨 5 点,所幸最后考过了。我应该会写一篇文章来专门谈谈这个考试。